“假声音”也来了,手把手教你造一只柯南的蝴蝶结变声器
视频中,特朗普用它一贯懒散的声音播报了一组耐人寻味的新闻——“数据雨“:

视频地址:https://www.youtube.com/watch?v=jzKlTKsHeus
虽然内容荒唐,但整个视频中的声音效果非常真实,以至于不少网友在捧腹大笑的同时也开始调侃,“是不是很快就能接到特朗普给我打的广告电话了。”
再加上近期,“假脸”技术大肆盛行,与之配套的“假声音”上线后,更能生成无缝衔接的假视频,让假戏做足,真假难辨。

一键生成“假声音”
关于变音技术,江湖上确实流传了几种,不过加持了机器学习和深度学习,这种技术不再是简单的语音滤波器。
跟”一键变脸“的deepfake软件一样,研究者们也开发了让不懂技术的同学直接易上手的变声软件。
刚刚听到的这个声音就来自这样一个网站Modulate.ai。麻省理工科技评论的资深编辑Will Knight用其轻易就合成了不同的声音。
创建这个网站的三个小伙伴,有两个来自麻省理工,还有一个来自加州大学洛杉矶分校。对于游客,这个网站给出了几个适用的声音,对于想定制名人声音的用户,还得通过官网给出的联系方式联系他们。
据网站介绍,合成的声音是是采用神经网络训练来训练,具有低延迟性以及实时性。
文摘菌试了一把,在网站的提供的接口处录下声音,选择你想要的“性别”或者“名人”,网站会很快生成你想要的声音。

语音转语音的具体过程
总的来说,所要建立的系统是:把一个说话人的声音的频率分布(frequency profile)换成另一个声音的频率分布,同时保持他们讲话的其余属性不变。
所以,自然的将系统分为两个部分:1、语音识别 2、语音转换。这两个部分最主要的区别是,是从语音转换到文本,还是从文本转换到语音。如果这两个部分独立运行,那么整个系丢失“情感模仿”。
语音转文本和文本转语音同属一个极端的情况。语音转换必须使用媒介,由于系统只能给出语音,并且尝试在输出中再现输入的语句。
破解瓶颈的主要方法是调整信息瓶颈的带宽。例如文本中间表示,会丢失太多信息。文本可以使用情感标签或其他符号进行注释,但这些需要对监督数据着重进行手动注释。
然后继续改进系统系结构,通过直接优化语音转换目标,通过一个新的说话人标识符,能够产生与目标声音紧密匹配的合成语音,同时保留了通常由瓶颈架构丢失的表达性。
AI合成大事件
通过AI技术合成图片以及视频早已不新鲜,要说最著名的合成案例可能就是下面这个。
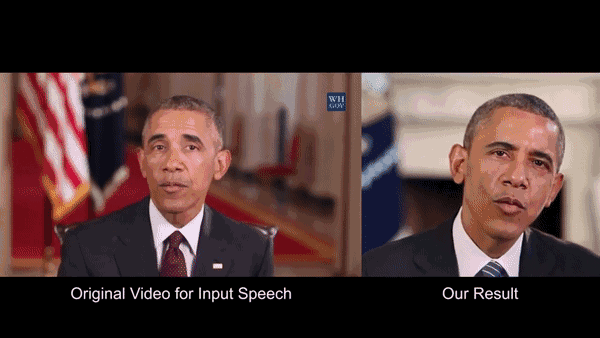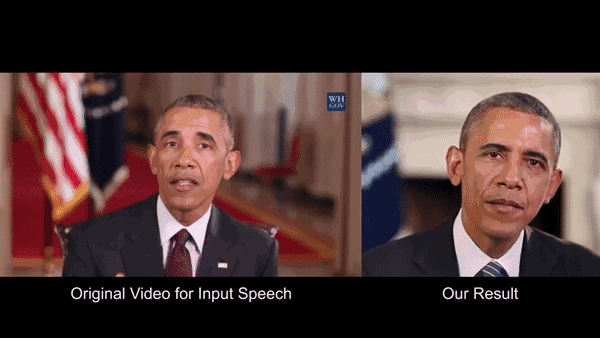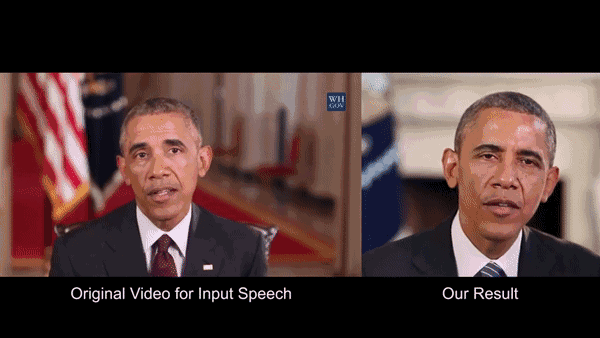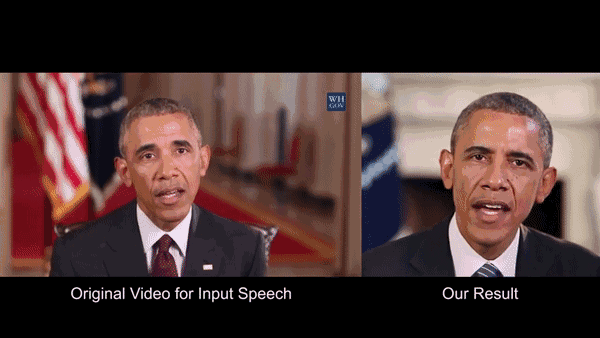
这项技术由华盛顿大学SUPASORN SUWAJANAKORN等三人共同发明,他们坦言,之所以选用奥巴马做研究范例,是因为他的高清视频资源获取非常容易,并且不受版权限制。
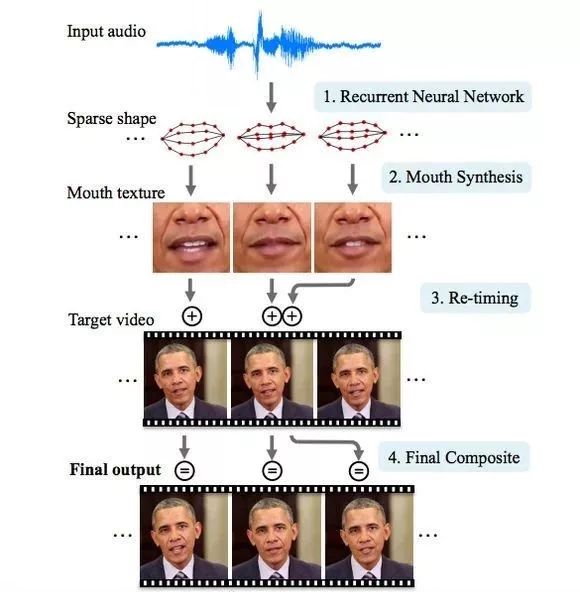
具体的操作过程是:研究人员采集了音频片段(原始音频文件),再把口型和新的音频文件剪辑匹配,再嫁接到新视频。
